✨ 核心功能特性
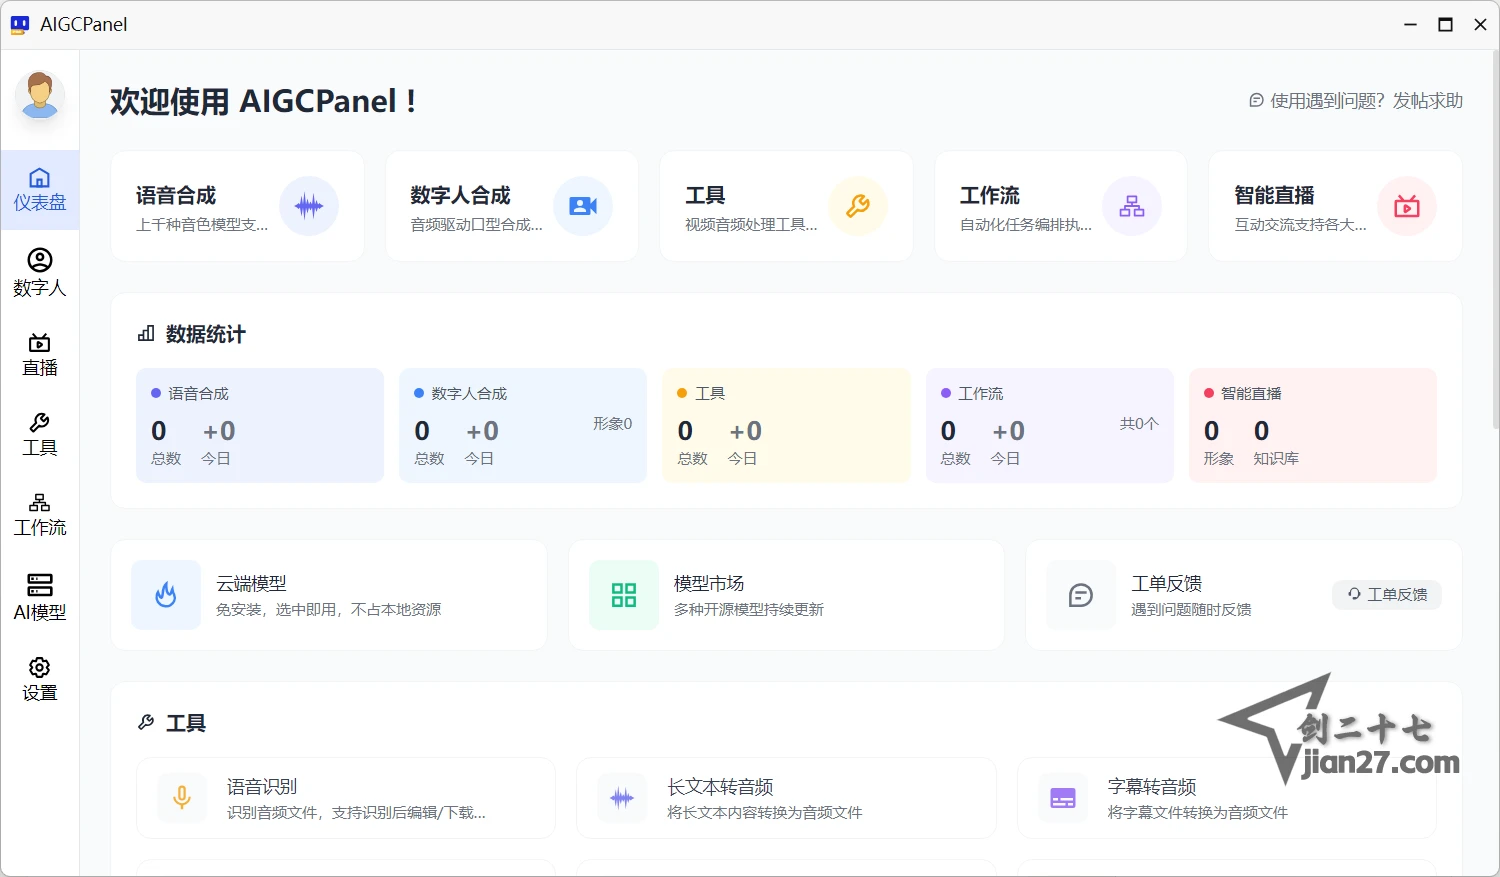
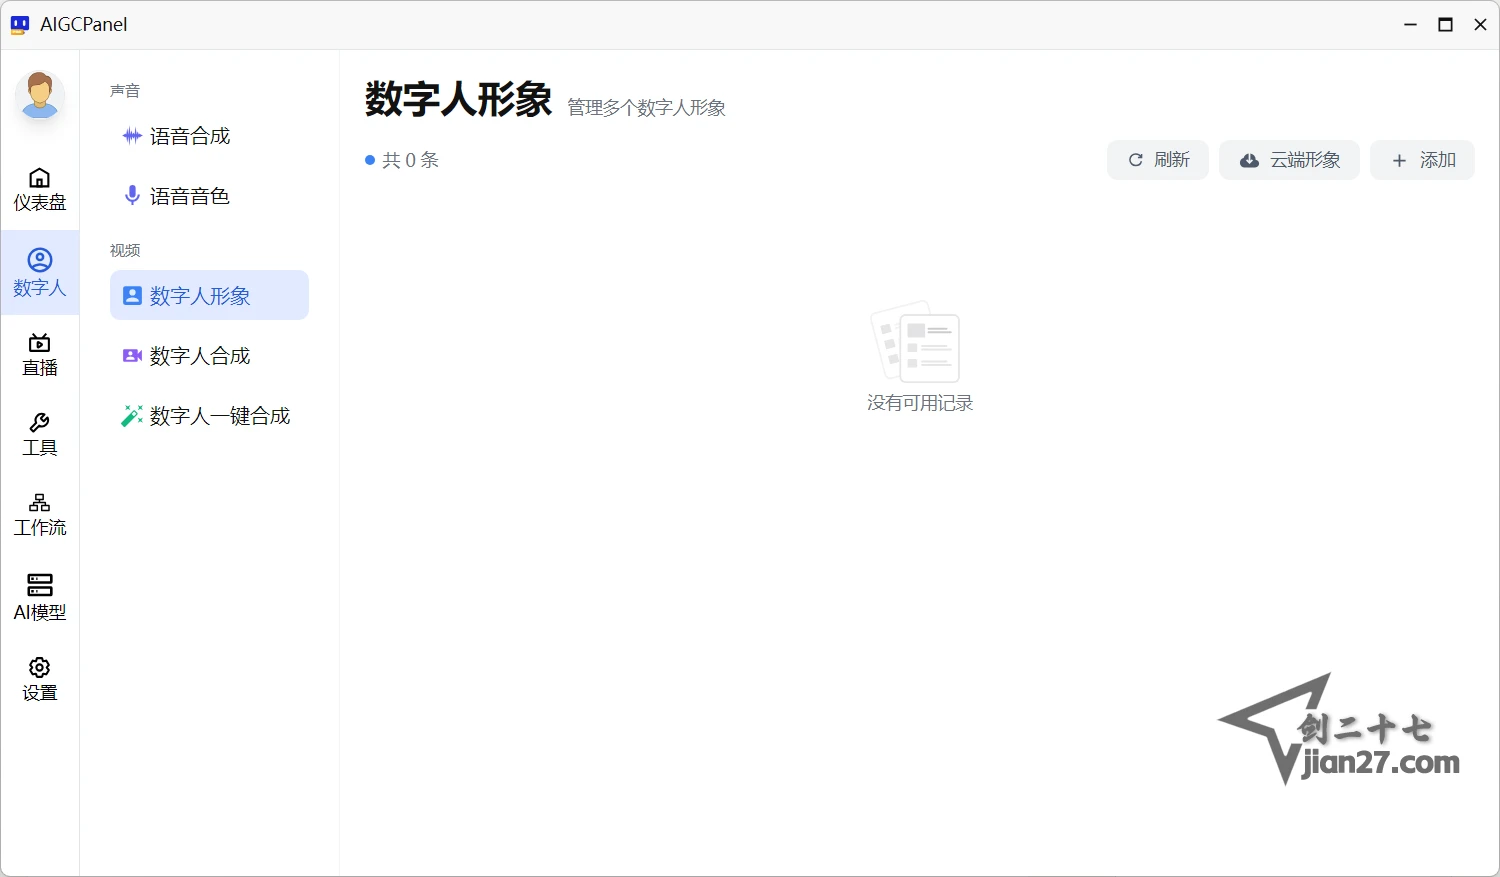
数字人视频合成
基于多种开源口型同步模型(MuseTalk / LatentSync / Wav2Lip / Heygem),可将任意音频与人物视频精准对齐。
支持直接输入文本由语音模型合成后驱动,或上传本地音频文件驱动。
支持绿幕视频形象,并内置形象模板管理。
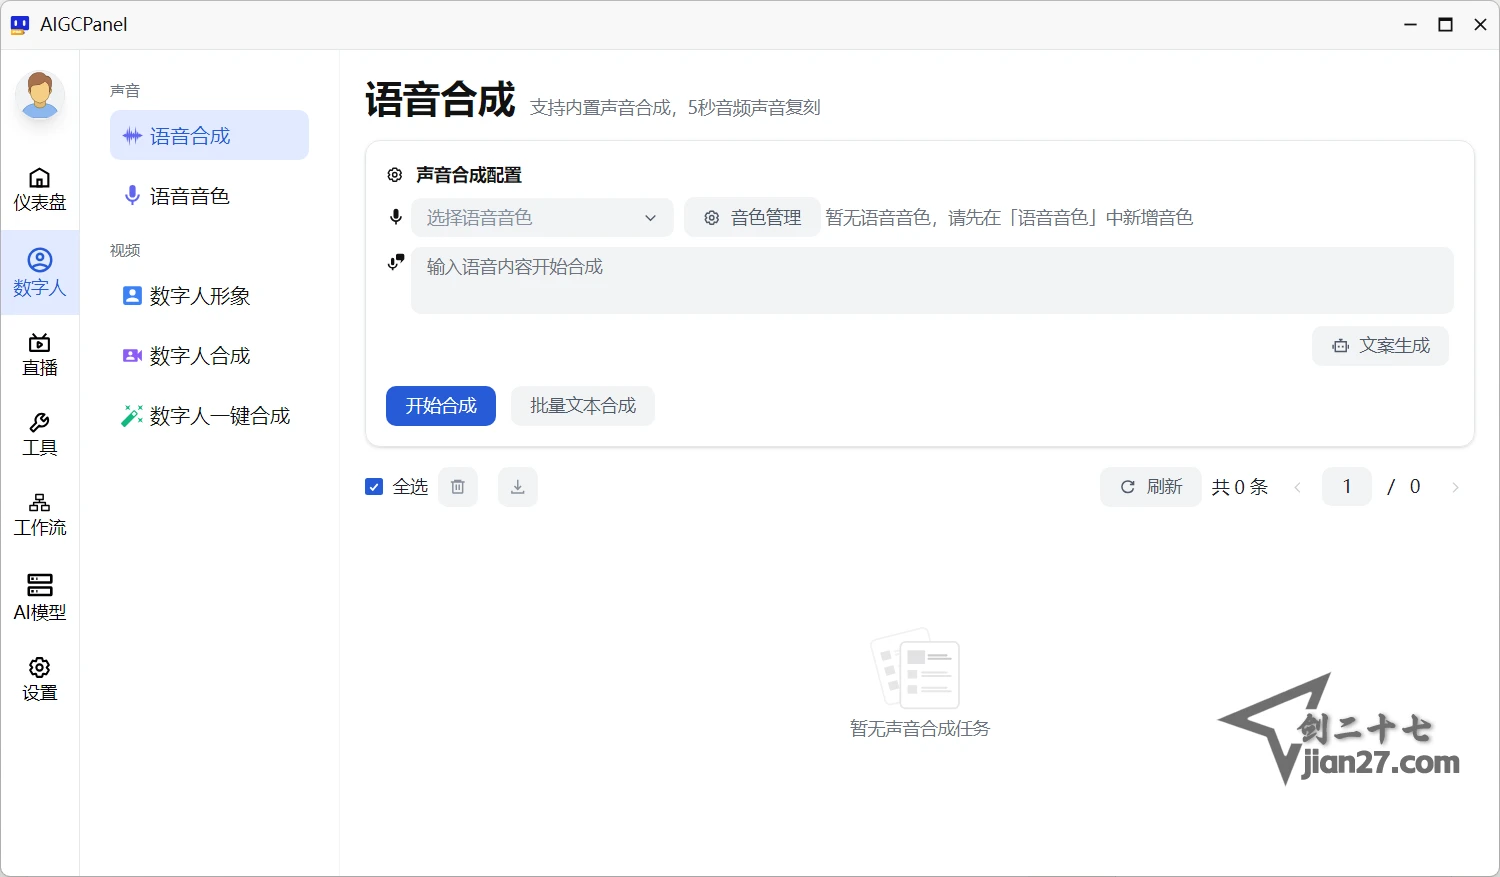
专业语音处理
语音合成 (TTS):支持多模型,可调速度、音调等参数。
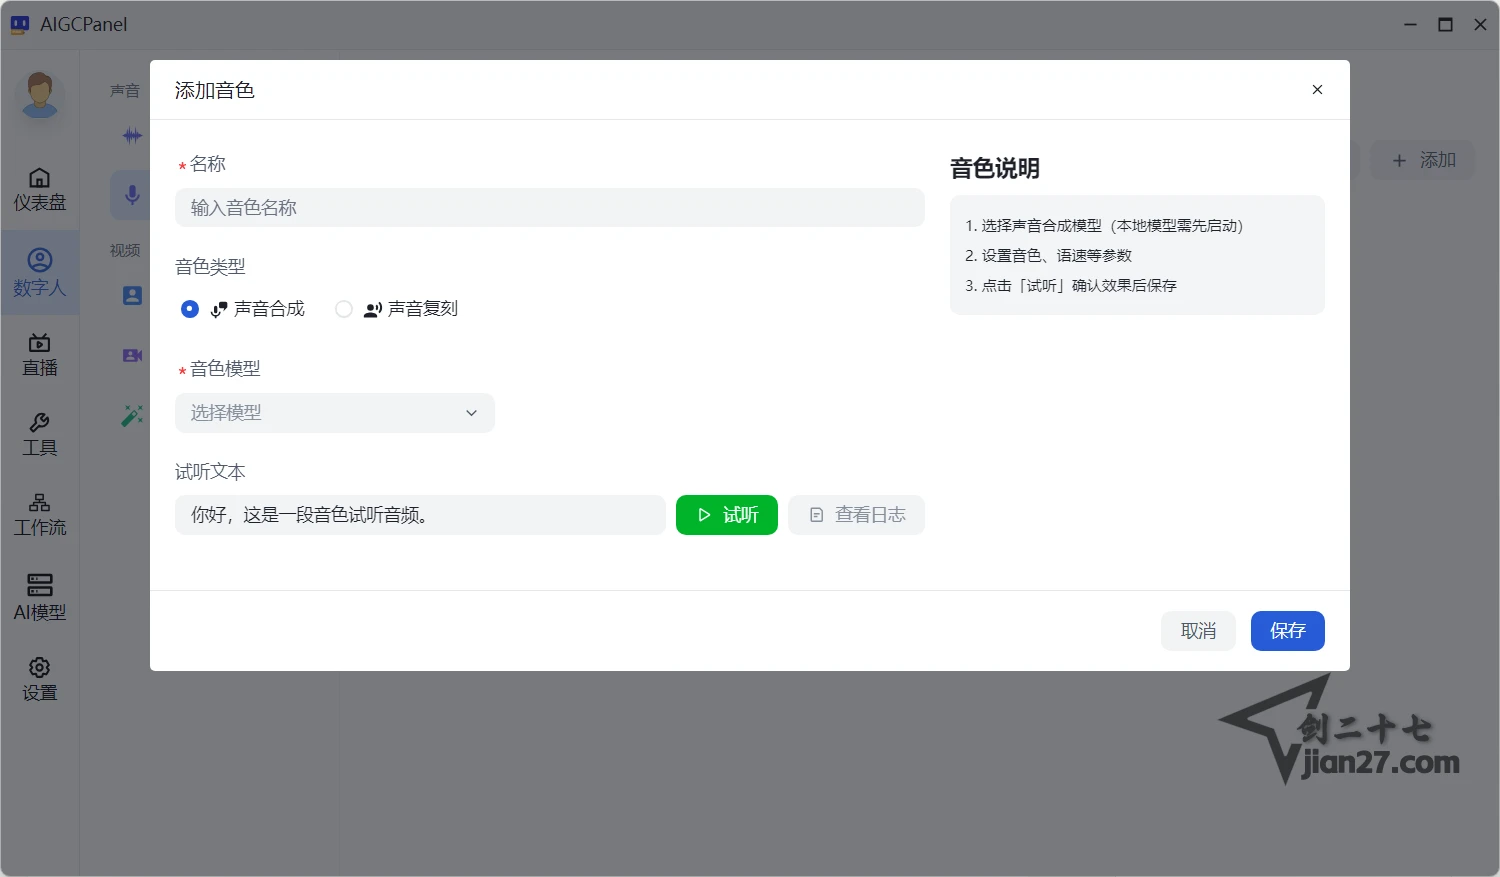
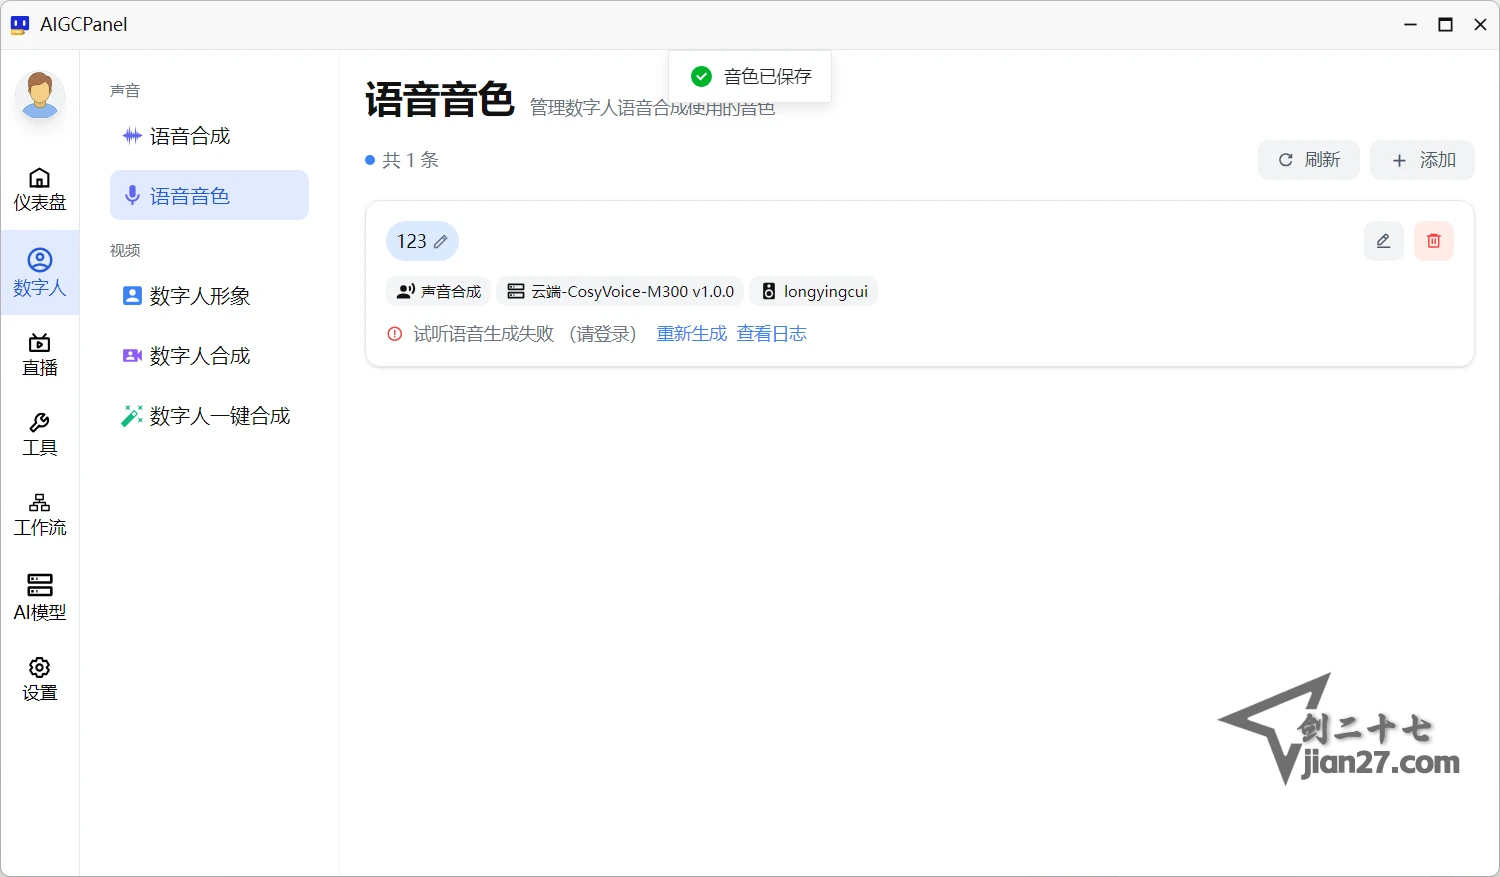
声音复刻:上传少量参考音频即可复刻特定音色(零样本/少样本)。
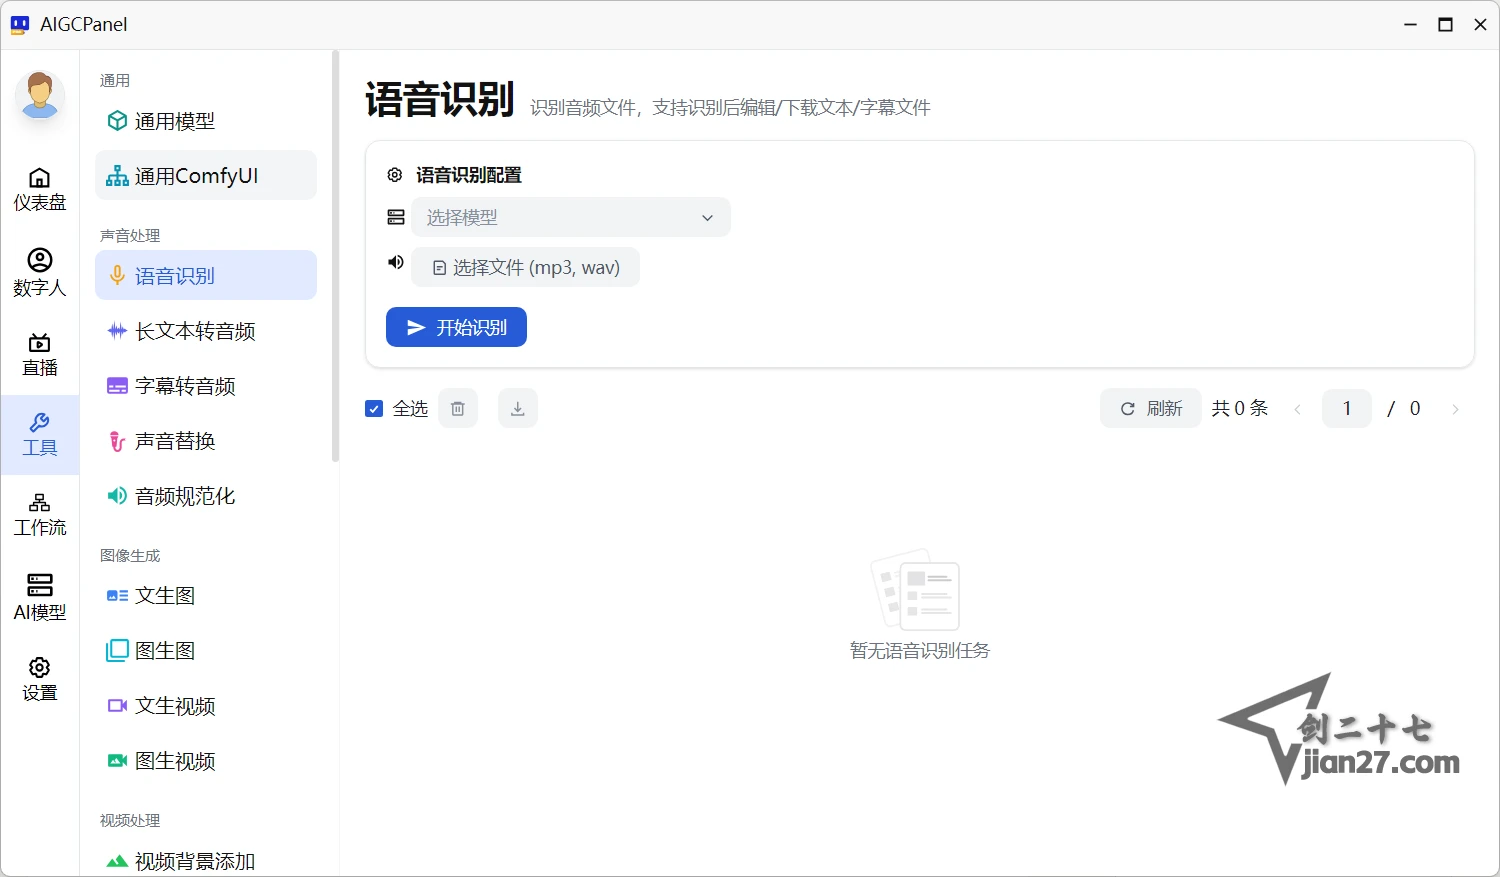
语音识别 (ASR):输出带时间戳的文字,支持一键导出为字幕文件。
声音替换:一键将现有视频的音轨替换为新生成的合成音频。
全能工具箱(25+ 工具)
音频类:长文本转音频、字幕转音频、音频规范化等。
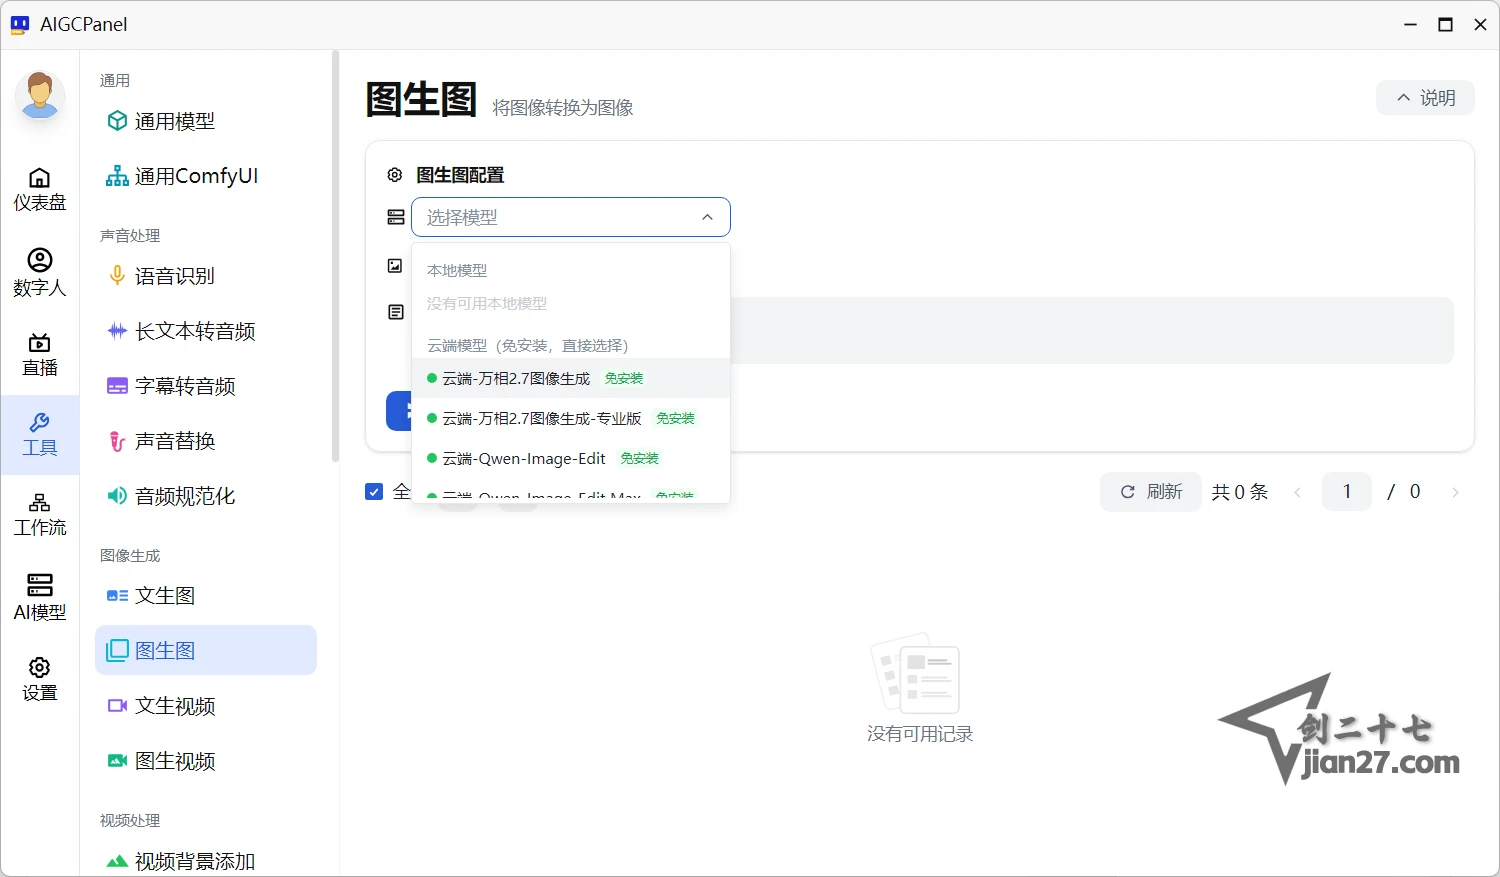
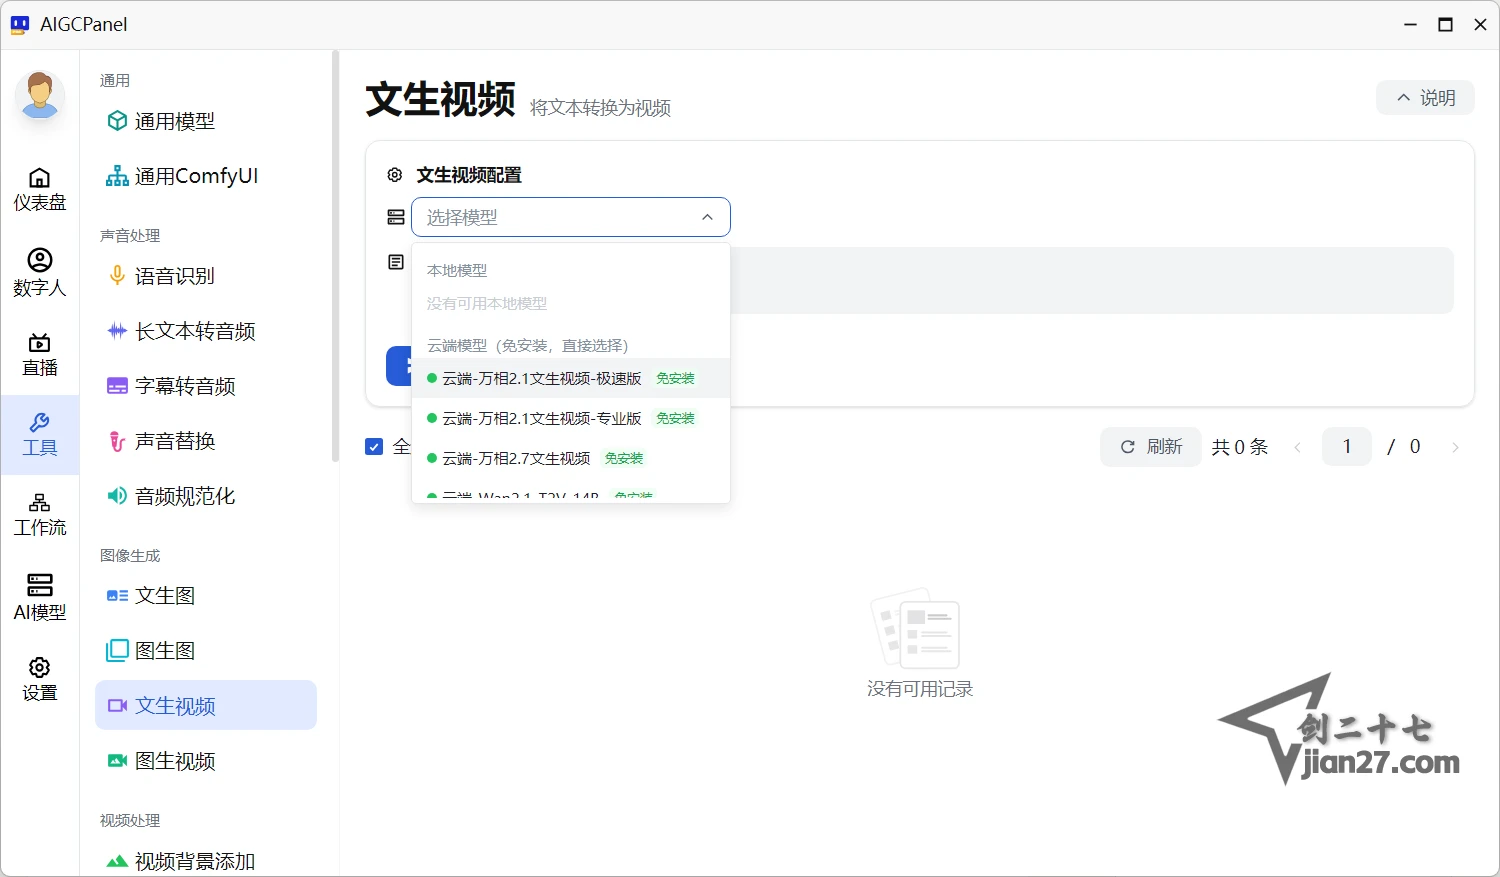
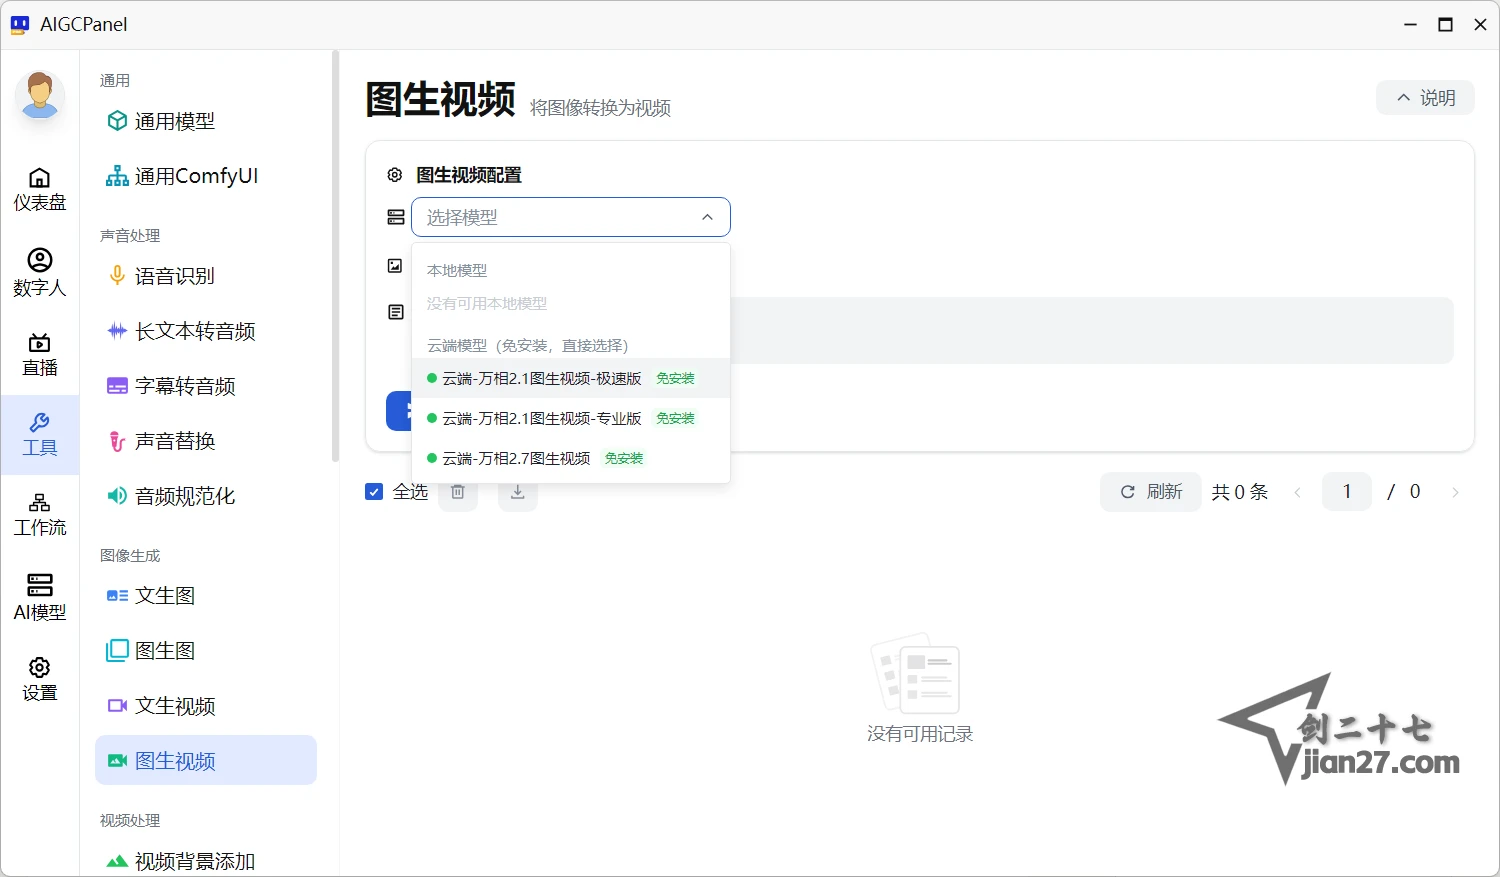
图像类:文生图、图生图。
视频类:背景添加、智能剪辑、片段放大/变速/删除、添加字幕/片头片尾、视频合并、格式转换、压缩以及 FFmpeg 自定义操作。
可视化工作流编排(Pro/VIP 功能)
提供拖拽式节点画布,支持将大模型(LLM)、JS 脚本、条件分支、MCP 工具调用、文件操作、正则提取以及所有工具箱节点串联成自动化流水线。
支持断点续跑、节点级状态追踪和运行历史查看。
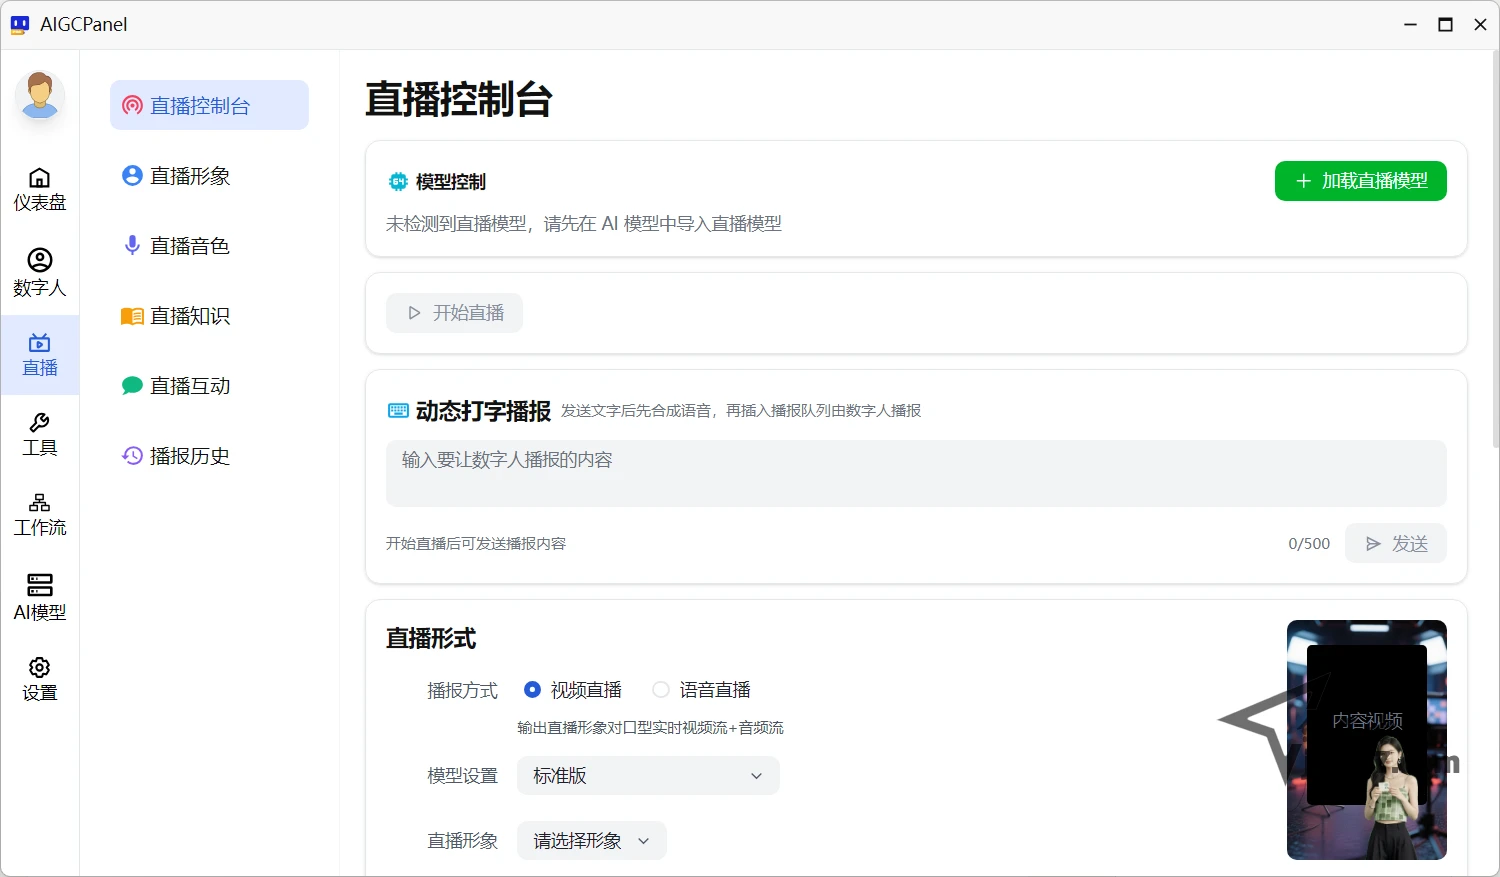
智能直播互动(Pro/VIP 功能)
支持抖音、哔哩哔哩、虎牙、斗鱼、快手等主流平台的弹幕实时监控。
可配置知识库(问答流程、视频播放流程),实现根据弹幕内容自动触发语音或视频播报。
支持违禁词检测与自定义回复 Prompt。
灵活的 AI 模型管理
内置模型市场,支持一键下载模型启动包,开箱即用。
统一管理本地模型(一键启动/停止、日志查看、参数配置)和远程 API 模型。
支持云端 AI 模型服务调用(无需本地高性能显卡)。
🧠 支持的主流开源模型
🛠️ 技术栈
桌面框架:Electron
前端框架:Vue 3 + TypeScript
UI 与样式:Arco Design(字节跳动) + TailwindCSS
构建工具:Vite
本地存储:better-sqlite3
工作流引擎:LogicFlow